
一、 前言
在前面 28 天的旅程中,我們陸續完成了對話、文字筆記、語音朗讀、隨堂考、番茄鐘、知識圖譜、RAG 多講義問答、錯題診斷、儀表板與成就徽章。但在真實學習場景中,學生經常遇到的是「課本上的算式圖表」、「考卷題目照片」或是「老師手寫的白板筆記」。今天,我們要導入 Gemini 強大的多模態(Multimodal)視覺能力,讓學生拍照就能輕鬆發問!
二、 核心技術與實作亮點
1.PIL 圖像處理與預覽:
整合 Pillow (PIL) 模組處理使用者上傳的各種圖片格式(JPG/PNG),並在 Streamlit 前端提供即時影像預覽。
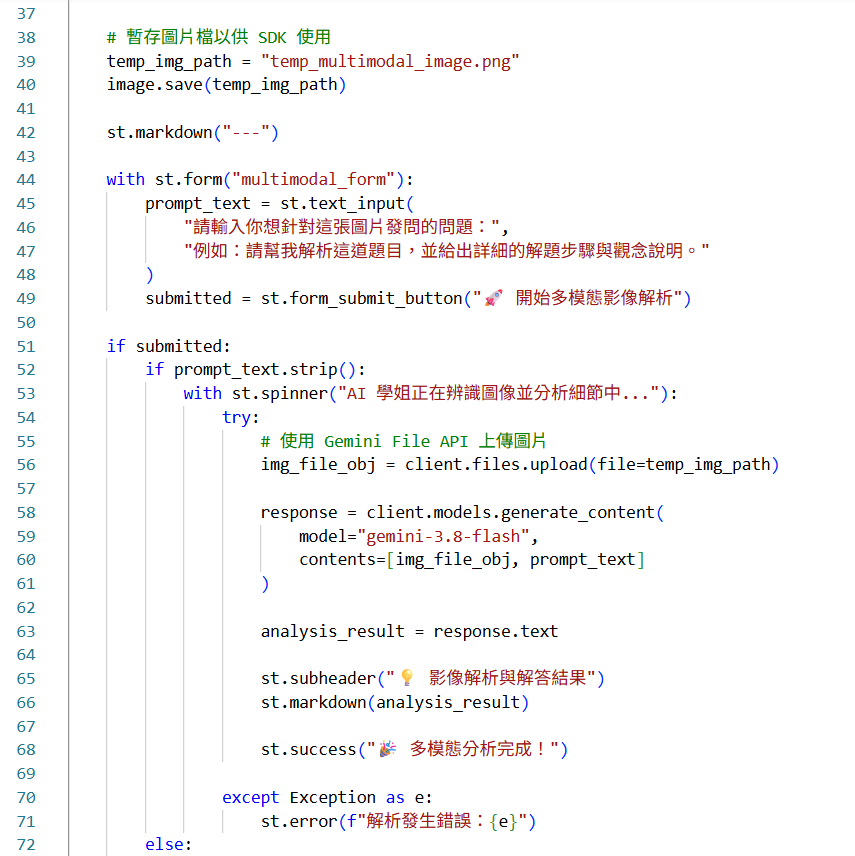
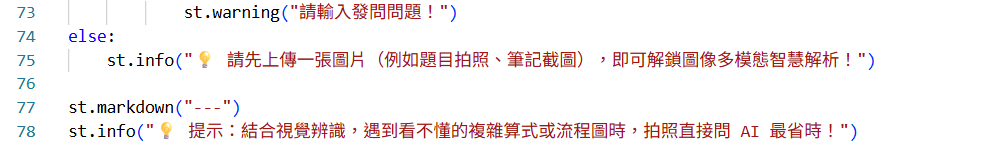
2.Gemini 視覺多模態 API 串接:
透過 client.files.upload 將圖片物件打包傳送至 Gemini 2.5/3.8 模型,實作「圖文混合提示詞(Image + Text Prompt)」的強大推理。
3.無縫學習場景覆蓋:
不論是解題、流程圖說明還是手寫字跡辨識,都能在一秒內取得極具條理的解答與分析。
三、實作
在 pages 資料夾中,新增一個新檔案並命名為:10_📸_多模態全能助理.py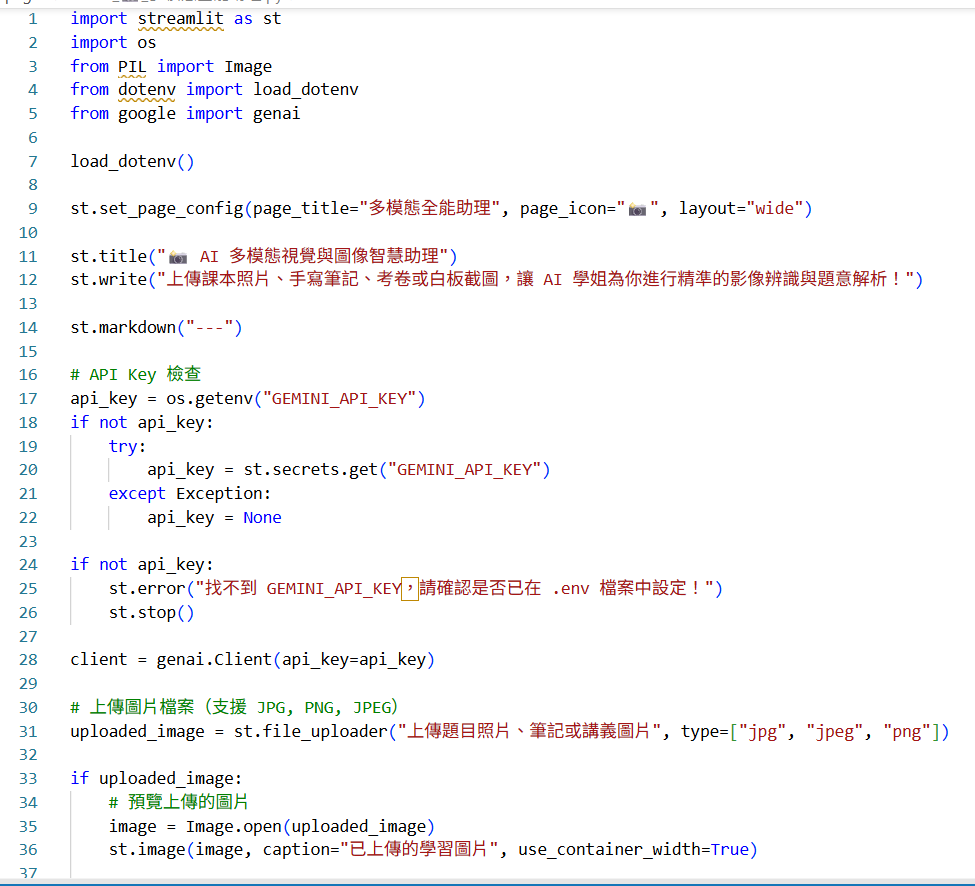
四、成果展示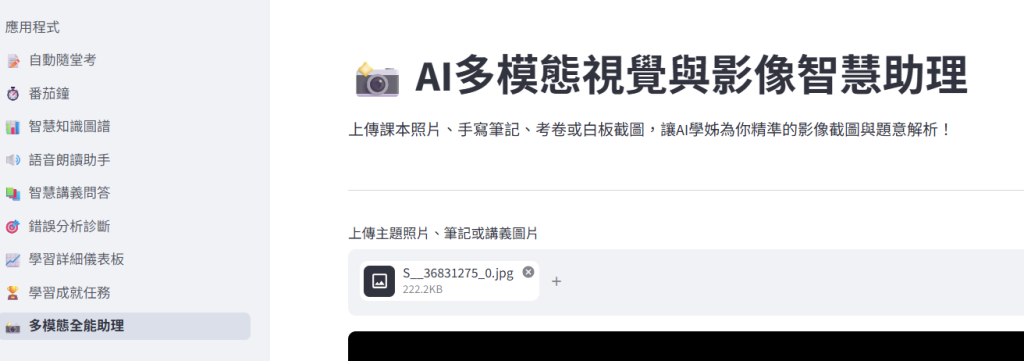
五、 結語
今天我們成功補齊了視覺多模態這塊最關鍵的拼圖!



 iThome鐵人賽
 看影片追技術